Showing posts with label performance. Show all posts

Sep 30, 2019

Bug 24590018 on exadata SCM0 on TOP process CPU Consumption.


First of all: Sorry for my languaje, my english is not very rich, 😔


Straight to the point ... 

Some days ago i was working in a database migration from Onprem to cloud environment (Exadata), and i could see that scm background process it was on TOP con CPU consumption (it was so weird because that database was inactive without active users on it)


TOP example:
op - 13:31:04 up 72 days, 11:01,  4 users,  load average: 13.41, 9.01, 7.45
Tasks: 5896 total,  13 running, 5870 sleeping,   0 stopped,  13 zombie
%Cpu(s): 22.0 us,  2.6 sy,  0.0 ni, 75.1 id,  0.0 wa,  0.0 hi,  0.1 si,  0.1 st
KiB Mem : 74261779+total,  5118632 free, 57913158+used, 15836755+buff/cache
KiB Swap: 16777212 total, 16776784 free,      428 used. 14184574+avail Mem

   PID USER      PR  NI    VIRT    RES    SHR S  %CPU %MEM     TIME+ COMMAND
 74136 oracle    20   0 8299256  89592  82416 R  98.4  0.0  30840:38 ora_scm0_ctmtst
265577 oracle    20   0   79.7g 865372  85984 R  98.4  0.1   1518:56 oracle
343847 oracle    20   0   80.3g 117968  85712 R  67.7  0.0   8:10.80 oracle
 49052 odhagent  20   0   25.7g 464020  10012 S  28.8  0.1   4959:42 java
 24823 root      20   0 6273548 822004  61116 S  24.1  0.1   1526:05 ohasd.bin
  1887 oracle    20   0 8282336  99408  91092 S  22.6  0.0   0:00.72 oracle_1887_ctm
  1863 oracle    20   0 8413404  99384  91068 S  22.3  0.0   0:00.71 oracle_1863_ctm
393677 oracle    20   0   79.0g  84496  70540 S  22.3  0.0   0:02.01 oracle
396019 oracle    20   0  180680  82388  28944 S  21.9  0.0   0:04.45 rman
  1872 oracle    20   0 8413408  98800  90480 S  21.6  0.0   0:00.69 oracle_1872_ctm
  1877 oracle    20   0 8282332  98908  90572 S  21.6  0.0   0:00.69 oracle_1877_ctm
255797 oracle    -2   0 7749688  63404  59912 S  21.6  0.0   1159:44 ora_vktm_ctmts5
396710 oracle    20   0  180692  82420  28992 S  21.6  0.0   0:04.43 rman
  1867 oracle    20   0 8544480  98284  89968 S  21.3  0.0   0:00.68 oracle_1867_ctm

We can also observe that process it had 514 hrs aprox. or 21 days aprox. of CPU consumption, awesome 😳🤨

Although i had the instance running only few days ago, i cloud see that BG procces SCM it was on TOP of the list : / very weird. Well, that behaviour is a issue, specific this:
12.2 RAC DB Background process SCM0 consuming excessive CPU (Doc ID 2373451.1)

That is a bug: Bug 24590018 - RAC PERF: SCM0 PROCESS USING 100% CPU, FG'S USING ~80% SYS CPU POSTING SCM0

From the note the support mentions us the solution: 

The DLM Statistics Collection and Management slave (SCM0) is responsible for collecting and managing the statistics related to global enqueue service (GES) and global cache service (GCS). This slave exists only if DLM statistics collection is enabled.
The value is set to 1. Please go ahead and run the following command to change the value of _dlm to 0:
kill -9 <os pid of SCM0>


alter system set "_dlm_stats_collect" = 0 scope = spfile sid = '*';
This does require a reboot for changes to take effect. If a reboot is not an option, as a workaround you may kill the SCM0 process at OS level, it will respawn a new process soon.

Disabling DML STAT COLLECT has no negative impact on performance or other things on 12.2. However on 18c or 19c it should be enabled again. For the moment there are not report this negative behaviour on the last database versions.

Jul 14, 2019

Algunas conceptos de SQL_ID, HASH_VALUE, etc..


Una aclaración corta pero necesaria del SQL_ID.

Oracle cuando realiza parsing de una consulta, genera con un algoritmo un Hashing MD5 de 128 bits de largo para cada consulta. Luego toma los últimos 64 bits de dicho hashing y crea lo que conocemos hoy en día como SQL_ID, el cual tiene 13 caracteres de largo. Este se compone de una mezcla de números y letras (base32), es decir 32 caracteres en total que serán usados para dar forma al hashing de SQL_ID final (de 13 caracteres).

Por ejemplo si ejecutamos una simple consulta como: select * from dual ; veremos que en el interior de la shared_pool se creará un nuevo SQL_ID, seguido de un hash_value. Ejemplo:


SQL> select * from dual;

D
-
X

SQL> 
SQL> select sql_id, hash_value from v$sql
where sql_text = 'select * from dual';  2  

SQL_ID       HASH_VALUE
------------- ----------
a5ks9fhw2v9s1  942515969


Lo anterior entrega el SQL_ID: a5ks9fhw2v9s1 y a partir de dicho SQL_ID oracle también crea el valor del identificador HASH_VALUE. Este valor era el que se usaba para identificar a una consulta en las versiones oracle 9i hacia atrás. Hay una diferencia eso si que cabe recalcar, en oracle9i y en oracle10g el algoritmo que se ocupa para crear ese hash_value es distinto. La vista GV$SQL o V$SQL posee la columna old_hash_value para mostrar también el valor hash_value que tendría nuestro SQL_ID pero como si fuese visto sobre un motor oracle9i o anterior.

A modo de ejemplo oracle crea el hash_value de la consulta ocupando el siguiente algoritmo (ocupando como parámetro el SQL_ID):

(la consulta original está en la página del genial TanelPoder, abajo en la bibliografia se encuentra el link original)

select
trunc(mod(sum((instr('0123456789abcdfghjkmnpqrstuvwxyz',substr(lower(trim('a5ks9fhw2v9s1')),level,1))-1)
                       *power(32,length(trim('a5ks9fhw2v9s1'))-level)),power(2,32))) hash_value
from
    dual
connect by
    level <= length(trim('a5ks9fhw2v9s1'))

Si ejecutamos la consulta usando el sql_id del ejemplo anterior para la query "select * from dual", veremos que entrega el mismo hash_value visto en la consulta anterior:

HASH_VALUE
----------
 942515969


Como mencionamos anteriormente el sql_id es una mezcla de hashing md5 y funciones Hexadecimales con 32 caracteres que retorna un número de 13 dígitos de largo. El algoritmo usado para generar lo anterior que mencionamos que da forma al SQL_ID, puede ser visto con la siguiente función que ha creado el señor Carlos Sierra (al final se encuentra el link hacia la fuente original)

CREATE OR REPLACE FUNCTION compute_sql_id (sql_text IN CLOB)
RETURN VARCHAR2 IS
 BASE_32 CONSTANT VARCHAR2(32) := '0123456789abcdfghjkmnpqrstuvwxyz';
 l_raw_128 RAW(128);
 l_hex_32 VARCHAR2(32);
 l_low_16 VARCHAR(16);
 l_q3 VARCHAR2(8);
 l_q4 VARCHAR2(8);
 l_low_16_m VARCHAR(16);
 l_number NUMBER;
 l_idx INTEGER;
 l_sql_id VARCHAR2(13);
BEGIN
 l_raw_128 := /* use md5 algorithm on sql_text and produce 128 bit hash */
 SYS.DBMS_CRYPTO.hash(TRIM(CHR(0) FROM sql_text)||CHR(0), SYS.DBMS_CRYPTO.hash_md5);
 l_hex_32 := RAWTOHEX(l_raw_128); /* 32 hex characters */
 l_low_16 := SUBSTR(l_hex_32, 17, 16); /* we only need lower 16 */
 l_q3 := SUBSTR(l_low_16, 1, 8); /* 3rd quarter (8 hex characters) */
 l_q4 := SUBSTR(l_low_16, 9, 8); /* 4th quarter (8 hex characters) */
 /* need to reverse order of each of the 4 pairs of hex characters */
 l_q3 := SUBSTR(l_q3, 7, 2)||SUBSTR(l_q3, 5, 2)||SUBSTR(l_q3, 3, 2)||SUBSTR(l_q3, 1, 2);
 l_q4 := SUBSTR(l_q4, 7, 2)||SUBSTR(l_q4, 5, 2)||SUBSTR(l_q4, 3, 2)||SUBSTR(l_q4, 1, 2);
 /* assembly back lower 16 after reversing order on each quarter */
 l_low_16_m := l_q3||l_q4;
 /* convert to number */
 SELECT TO_NUMBER(l_low_16_m, 'xxxxxxxxxxxxxxxx') INTO l_number FROM DUAL;
 /* 13 pieces base-32 (5 bits each) make 65 bits. we do have 64 bits */
 FOR i IN 1 .. 13
 LOOP
 l_idx := TRUNC(l_number / POWER(32, (13 - i))); /* index on BASE_32 */
 l_sql_id := l_sql_id||SUBSTR(BASE_32, (l_idx + 1), 1); /* stitch 13 characters */
 l_number := l_number - (l_idx * POWER(32, (13 - i))); /* for next piece */
 END LOOP;
 RETURN l_sql_id;
END compute_sql_id;
/

Si creamos esa función en nuestra BD y la ejecutamos indicando nuestro Statement completo como parámetro veremos el mismo SQL_ID que habíamos visto en la shared pool al comienzo:
SQL> SELECT compute_sql_id('select * from dual') sql_id from dual ;

SQL_ID
--------------------------------------------------------------------------------

a5ks9fhw2v9s1


Ahora surge una pregunta que muchas personas pueden hacerse ¿Puede repetirse un SQL_ID para dos consultas absolutamente distintas? La respuesta es SI. Ya en el hash_value las colisiones se sabia que podían existir (y eso que el algoritmo trabaja en ese caso con un Hashing de 32bits). Para evitar eso se creo el SQL_ID basado en un algoritmo que genera un número único mucho más largo. En algunas pruebas realizadas por un DBA del Cern llamado Luca Canali (a quien recomiendo leer mucho para eso ver link de su nota al respecto en la bibliografía) se encontró que se necesitaron generar casi 10billones de pruebas con consultas de texto similares para generar algunas pocas colisiones. Eso demuestra que actualmente el SQL_ID es la manera más eficiente de asegurar la identificación única para una consulta en la base de datos.

En resumen el SQL_ID es fruto de funciones Hexadecimales y conversiones MD5 que resulta en un número de 13 digitos, y el hash_value es formado por los últimos 32bits del hashing md5 del SQL_ID.

Aquí la bibliografía que recomiendo leer Bibliografía:
https://blog.tanelpoder.com/2009/02/22/sql_id-is-just-a-fancy-representation-of-hash-value/

Oct 23, 2017

TRCANLZR (TRCA): SQL_TRACE/Event 10046 Trace File Analyzer

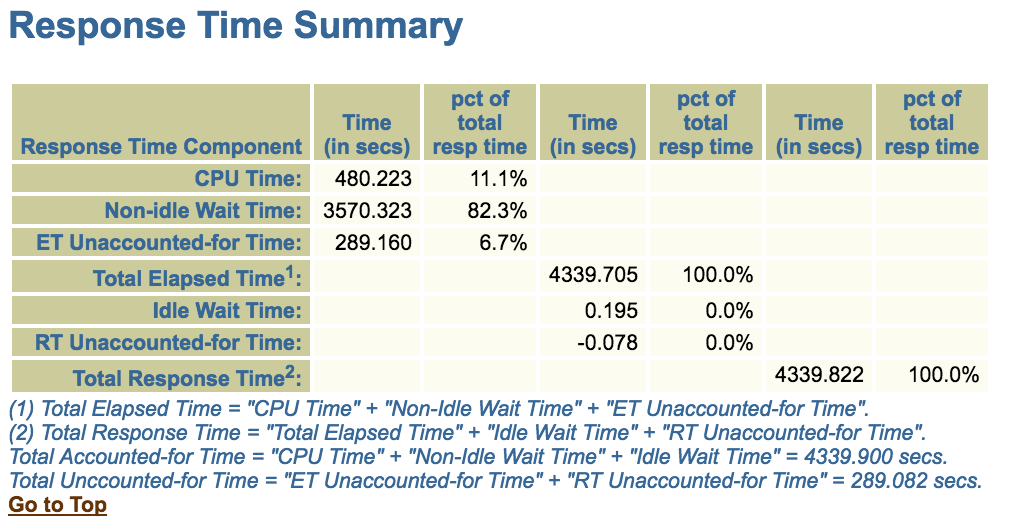
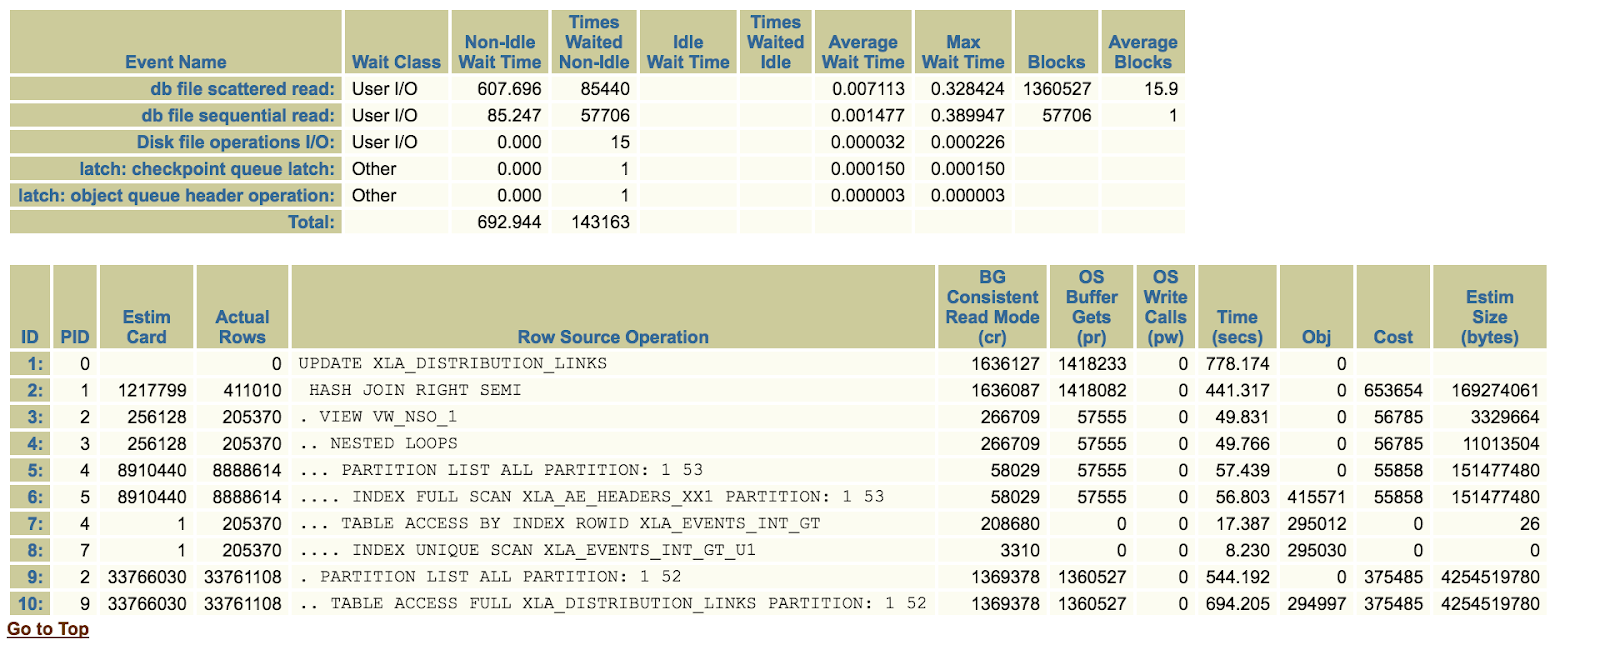
I want recommend you a tool very very useful for oracle traces analyzer, this tool is call: TRCANLZR (owner: Carlos Sierra, carlos.sierra@oracle.com). This tool allow you to summarize and describe trace files better than tkprof. It generates a HTML File with all information about the traces: top querys, top event waits, execution plans and much more:


Some Examples about the output after execution:


Full HTML Example about the output after execution traces analyzer:
In Metalink can see information about this tool in the note:
TRCANLZR (TRCA): SQL_TRACE/Event 10046 Trace File Analyzer - Tool for Interpreting Raw SQL Traces (Doc ID 224270.1)


The install tool is very simple:


1.- Uncompress the zip file.
2.- Enter the folder: trca/install
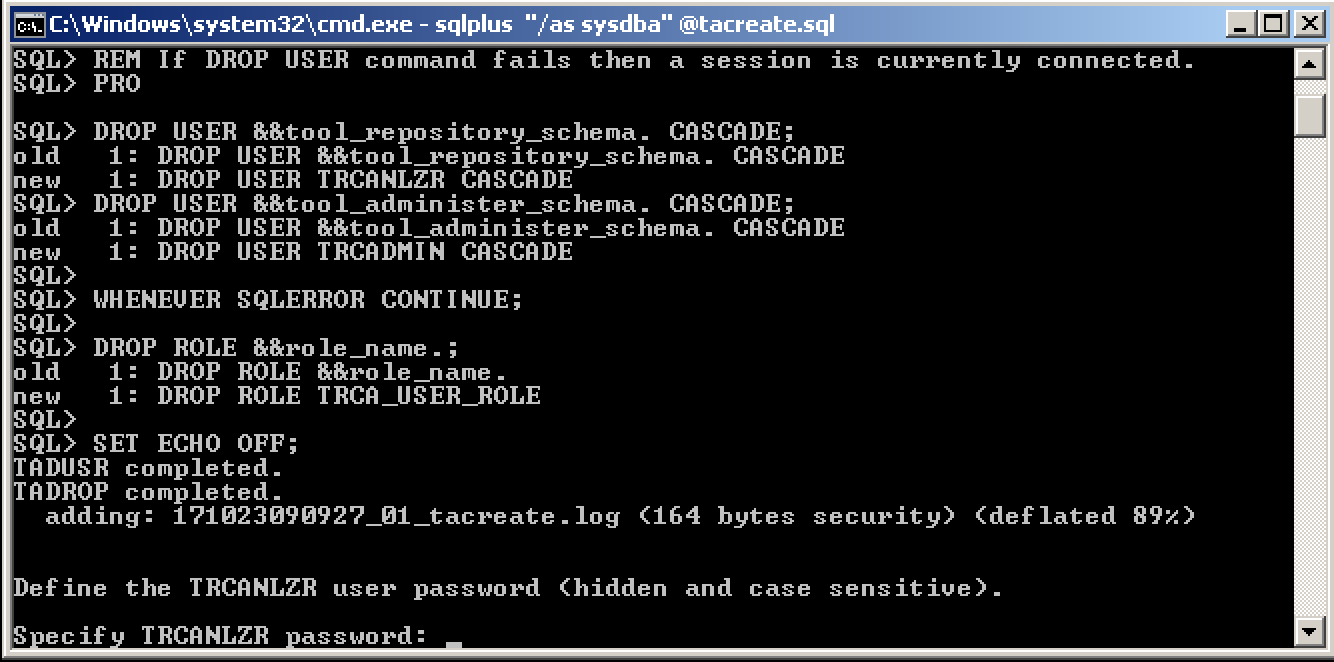
3.- Execute: sqlplus "/as sysdba" @tacreate.sql
This step is for create database schemas. The tool require a database instance.
4.- enter the folder diag/....trace/ (the folder where is located the database's alert log)
5.- In that directory copy the *.trc file what you will analyze.
6.- Go the folder trca/install
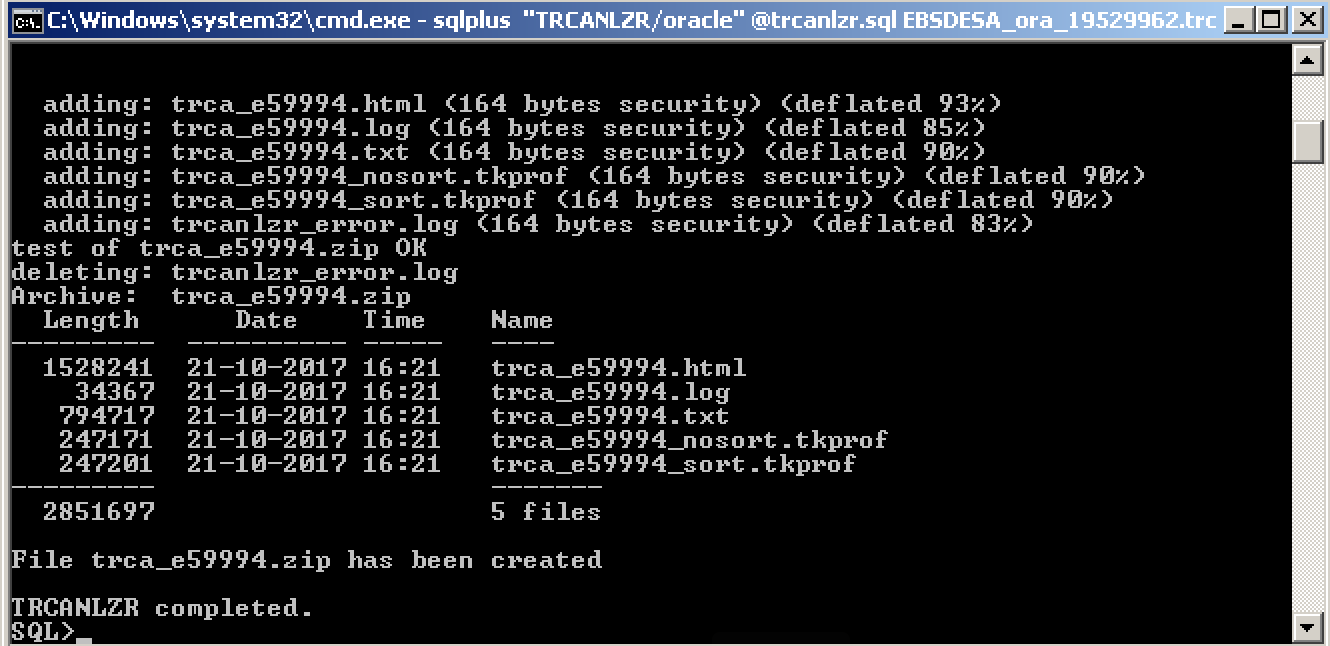
7.- Execute: sqlplus  "TRCANLZR/password_database" @trcanlzr.sql file_trace_to_analyzer.trc
8.- When the procesess finish, will be generated ZIP file on the folder trca\run


And open that zip file and you can see the HTML unique file with all results analyzer. (Example output: https://drive.google.com/uc?export=download&id=0B8Tjo6f10a1WbEVDaTBSNUpwd1E)


PD: For 9i trace files, you should to use this tool:
9i SQL Tuning Health Check Script SQLHC Doc ID 1366133.1


Link from author tool: https://carlos-sierra.net/2013/04/25/differences-between-tkprof-and-trace-analyzer-trcanlzr-trca/

Sep 13, 2016

¿Problema con almacenamiento de métricas por parte de performance monitor (de sqlserver o de discos) ?


Image result for microsoft


     Hace poco me ha sucedido que me encontré con que ciertas métricas de sistema operativo como métricas de disco y de sqlserver no se estaban guardando correctamente en la carpeta C:\perflogs. Esto fue sobre un ambiente Windows Server 2003 R2 de un cliente. Simplemente los archivos quedaban en blanco o el contador de rendimiento que habia creado se caia dejando un log de error. Hace poco habia creado una métrica de rendimiento para guardar el comportamiento de todos los discos de una máquina sobre la cual corria SQLServer. Mi sorpresa fue que el contador de rendimiento no queria echar a correr dejando el siguiente error:


Como podrán darse cuenta estaba intentando capturar el "Queue lenght" de los discos (en este caso la unidad P:\ ). Buscando documentación en microsoft encontré una serie de pasos que me llevaron a solucionar este problema (ojo que este inconveniente se me manifestó también con las métricas del sqserver , cualquiera de ellas que intentará capturar con dicho contador de rendimiento  daba error)

En el siguiente link están los pasos a lo largo un extenso foro que resumo a continuación:
https://social.technet.microsoft.com/Forums/windowsserver/en-US/4fb21c0d-8e80-4e65-8e9c-177d8b75db88/logicaldisk-perfmon-counter-generates-errors-event-id-2029-and-event-id-2028?forum=winservergen

(En este link también estan los mismos pasos para solucionar el problema)
https://support.solarwinds.com/Success_Center/Server_Application_Monitor_%28SAM%29/Performance_Counters_are_not_working_or_missing_in_PerfMon

Pasos a llevar a cabo:

1.- En el registro de windows  en la llave  MKEY_LOCAL_MACHINE\SYSTEM\CurrentControlSet\Services\PerfDisk\Performance dicha carpeta debe tener privilegios de lectura  para "everyone".

2.- En la llave mencionada anteriormente se encontrá una variable llamada "Disable Performance Counters" la cual debe estar seteada en 0. Si está con valor 1 las métricas de discos no serán recolectadas

3.- Navegar a la ruta: C:\Windows\System32 y buscar los siguientes archivos: perfc009.dat, perfd009.dat, perfh009.dat y perfi009.dat. Sobre dichos archivos dar privilegios de lectura a "everyone".

4.-  Ejecutar el siguiente comando en la ruta de windows: C:\WINDOWS\system32>lodctr /R
(lo anterior cargará nuevamente las métricas de rendimiento)

5.- Reiniciar el servicio de windows  "Performance Logs and Alerts"

Sinceramente el hecho de dar privilegio de lectura a "everyone" no me agrada mucho pero fue lo único que me permitió resolver el problema. Luego de lo anterior puedo recolectar métricas de discos y de sqlserver sin problemas. Ahora me he creado una nueva métrica y sin problemas obtengo la información de los discos:


Y finalmente puedo visualizar sin problemas los distintos gráficos de comportamiento: